


Trino 484 : les nouveautés, testées (JSON, EXCLUDE, Iceberg)
Trino 484 en sept requêtes
Trino 484 lit mieux le JSON, calcule des durées précises, ajoute la clause EXCLUDE et corrige des résultats faux. Nous avons testé chaque exemple sur la version précédente, puis sur Trino 484.
Sommaire
- Les sept nouveautés de Trino 484 en un coup d’œil
- Préparer le terrain
- Nouveauté 1 · JSON_TABLE lit enfin le type JSON
- Nouveauté 2 · Le JSON garde son ordre et ses nombres
- Nouveauté 3 · Des intervalles au type précis
- Nouveauté 4 · CREATE VIEW IF NOT EXISTS protège la vue existante
- Nouveauté 5 · EXCLUDE compare une ligne aux autres
- Nouveauté 6 · Des résultats faux corrigés
- Nouveauté 7 · Iceberg accepte sorted_by et gc_enabled
- Récapitulatif du tutoriel
- Et aussi
- Avant de migrer
- Testez-vous
- Ce que vous avez appris
- Questions fréquentes
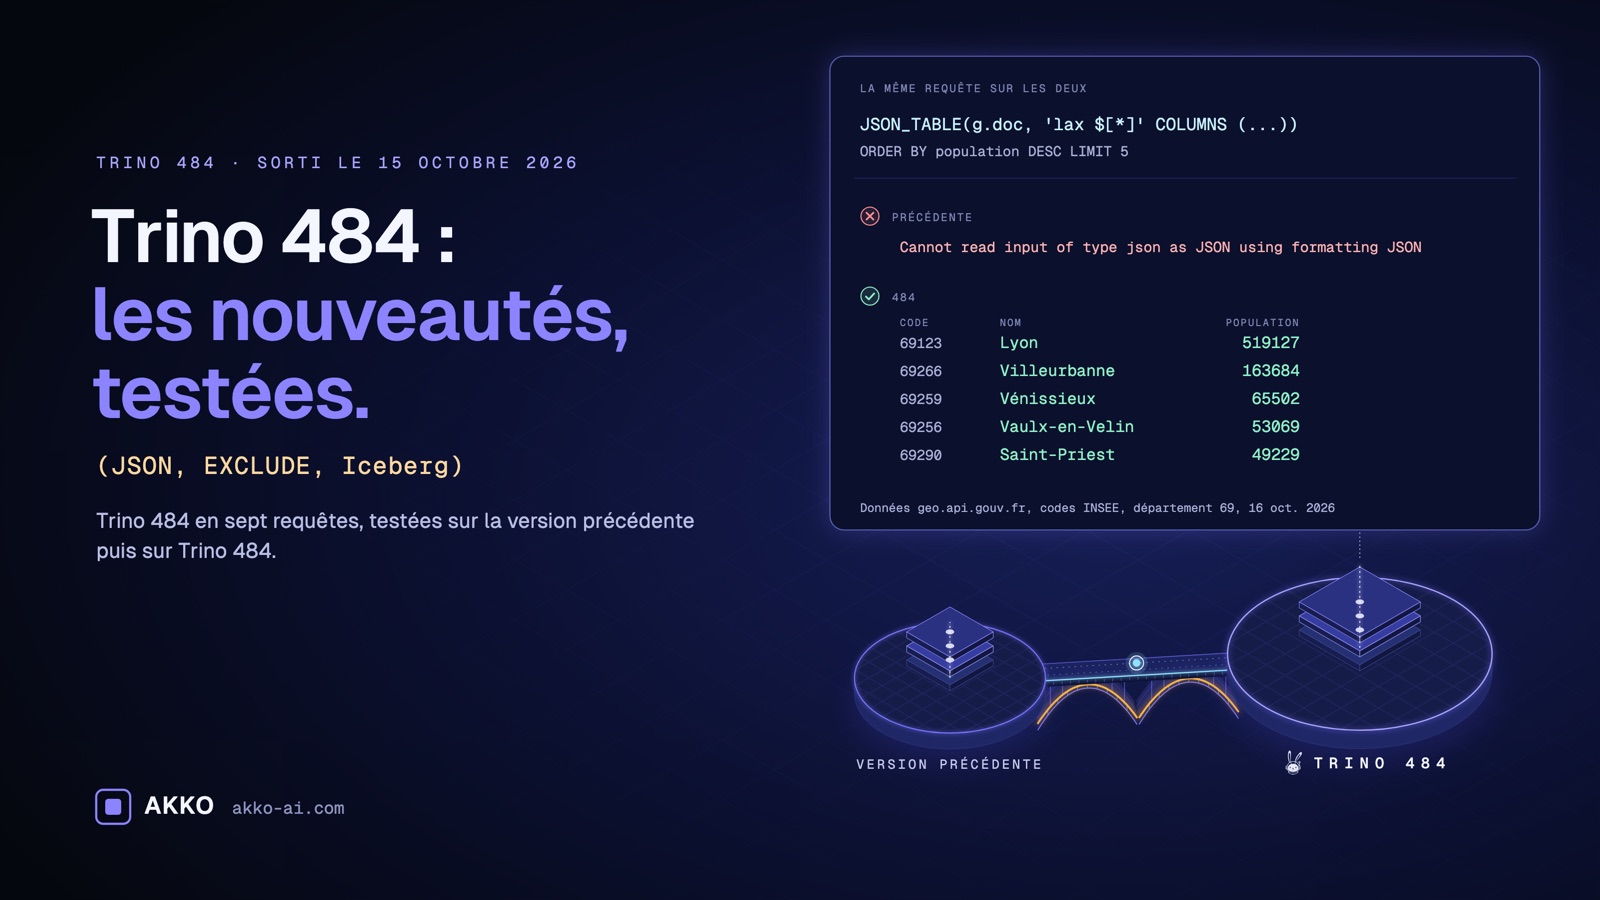
Voici la première commune que renvoie l’API Découpage administratif pour le département 69 : {"nom":"Affoux","code":"69001",...}. Chargez ce document dans Trino, puis affichez cette commune.
La version précédente affiche {"centre":...,"code":"69001",...,"nom":"Affoux","population":398}. Elle a trié les clés par ordre alphabétique, et le nom se retrouve à la fin. Trino 484 affiche {"nom":"Affoux","code":"69001",...} : il garde l’ordre de l’API.
Ce petit détail résume bien la version sortie le 15 octobre 2026. Trino suit de plus près la norme SQL, et il ne réécrit plus vos documents JSON.
Dans ce tutoriel, vous allez apprendre à :
- lancer Trino 484 sur votre poste en une commande ;
- lire une réponse d’API JSON comme une table, avec JSON_TABLE ;
- déplier un tableau imbriqué en lignes, avec NESTED PATH ;
- soustraire deux timestamps en choisissant les champs de l’intervalle obtenu ;
- créer une vue sans écraser celle qui existe ;
- comparer une ligne à la moyenne des autres, avec EXCLUDE ;
- repérer un résultat faux que Trino 484 corrige.
Les sept nouveautés de Trino 484 en un coup d’œil
Chaque nouveauté renvoie à sa section, avec une démonstration à rejouer.
hour(INTERVAL '36' HOUR) renvoie désormais 36, et non plus 12.Voir la nouveauté 3 →NOUVEAUCREATE VIEW IF NOT EXISTS protège la vue existanteUne vue est créée seulement si elle n’existe pas encore.Voir la nouveauté 4 →NOUVEAUEXCLUDE compare une ligne aux autresUne window function peut laisser la ligne courante de côté.Voir la nouveauté 5 →CORRIGÉDes résultats faux corrigésD’après notre comptage, 54 entrées (49 corrections distinctes) visent des requêtes qui donnaient un résultat faux sans aucune erreur.Voir la nouveauté 6 →NOUVEAUIceberg accepte sorted_by et gc_enabledLa compaction accepte un ordre de tri et, selon les release notes, gc_enabled = false protège les fichiers. Les vues matérialisées acceptent aussi COMMENT et optimize.Voir la nouveauté 7 →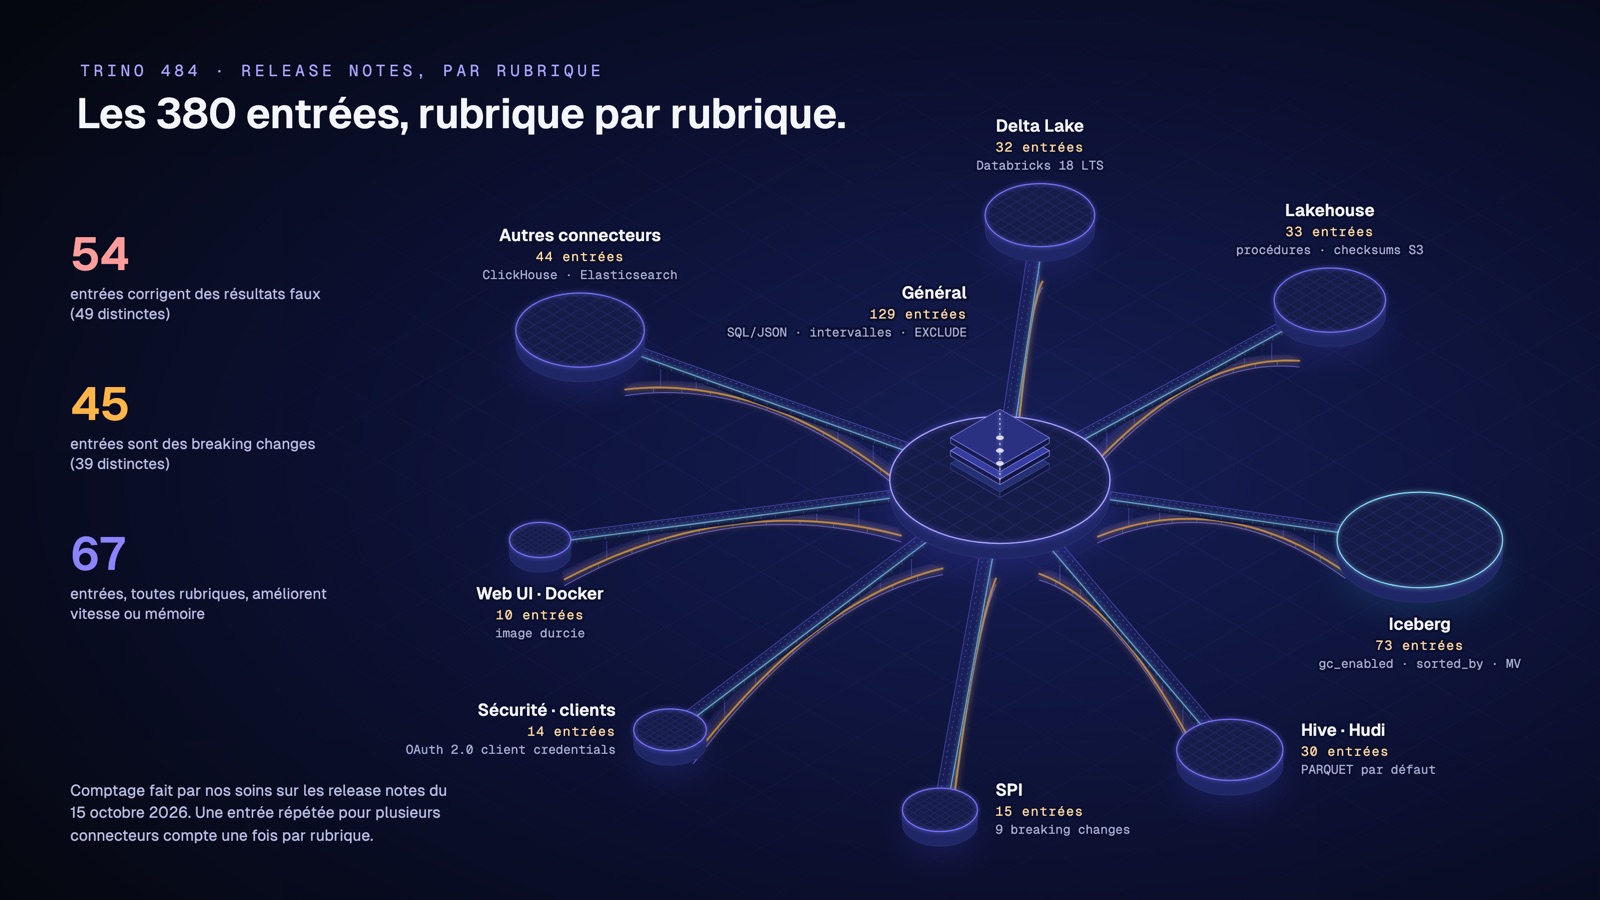
Cette carte répartit les 380 entrées des release notes par rubrique. Une même correction y revient souvent sous plusieurs connecteurs. D’après notre comptage, 54 entrées corrigent des résultats faux, soit 49 corrections distinctes. Et 45 entrées (39 distinctes) sont des breaking changes, c’est-à-dire des changements qui peuvent casser une requête qui marchait.
Préparer le terrain
Avant de découvrir les nouveautés, installez un Trino 484 sur votre poste et chargez de vraies données. Deux étapes suffisent.
Prérequis. Il vous faut Docker et environ 2 Go de mémoire libre. Vous savez écrire un SELECT avec un ORDER BY. Inutile de connaître Trino.
Récupérez le code. Toutes les commandes et requêtes de ce tutoriel tiennent dans deux fichiers à télécharger,
recuperer-donnees.shetrequetes.sql.
Étape 0 · Lancer Trino 484 en une commande
Trino est un moteur SQL : il interroge vos données sans les déplacer. Son image Docker officielle démarre un serveur complet. Elle contient déjà un catalog memory, c’est-à-dire une source de données qui garde ses tables en mémoire vive.
Lancez le conteneur en arrière-plan, avec 2 Go de mémoire au plus.
$ docker run -d --name t484-tuto --memory 2g trinodb/trino:484<identifiant du conteneur, 64 caractères>Docker affiche l’identifiant du conteneur. La commande suivante attend que le serveur écrive SERVER STARTED dans ses logs.
$ until docker logs t484-tuto 2>&1 | grep -q "SERVER STARTED"; do sleep 2; done; echo "Trino est prêt"Trino est prêtVérifiez ensuite qu’il répond. L’image contient déjà le CLI trino, l’outil en ligne de commande de Trino.
$ docker exec t484-tuto trino --execute "SELECT 1""1"Le CLI affiche "1", entre guillemets, car il écrit en CSV par défaut. Votre Trino 484 fonctionne.
Si ça ne marche pas. La commande
docker logs t484-tutoaffiche la cause. Le plus souvent, Docker manque de mémoire. Libérez-en, ou augmentez la mémoire allouée à Docker (réglage Resources de Docker Desktop).
Étape 1 · Charger les communes du Rhône
L’API Découpage administratif (geo.api.gouv.fr) publie les codes géographiques officiels de l’INSEE. Elle répond en JSON, un format texte très courant pour échanger des données structurées. Pour le département 69, elle renvoie 266 communes. Pour chacune, elle donne le nom, le code INSEE, la population, la liste des codes postaux et les coordonnées du centre. Sa fiche sur data.gouv.fr indique que « toutes les données utilisées sont sous licences Open Data ».
Téléchargez la réponse de l’API, puis vérifiez sa taille en octets.
$ curl -s "https://geo.api.gouv.fr/departements/69/communes?fields=nom,code,codesPostaux,population,codeEpci,centre&format=json" -o communes-69.json
$ wc -c < communes-69.json43024Le fichier fait 43 024 octets, comme lors de notre test du 16 octobre 2026. Sur macOS, wc ajoute des espaces devant le nombre. Ce n’est pas grave. Si l’API a changé depuis, la taille change, et certains chiffres plus bas aussi.
Créez ensuite un petit fichier SQL qui stocke tout le document dans une table, dans une seule colonne de type json. La commande sed double les apostrophes des noms comme « L’Arbresle ». Sans cela, SQL croirait que le texte s’arrête à l’apostrophe.
$ { printf "CREATE TABLE memory.default.communes_69 AS SELECT JSON '"; sed "s/'/''/g" communes-69.json; printf "' AS doc;\n"; } > charger.sql
$ docker exec -i t484-tuto trino < charger.sql
CREATE TABLE: 1 rowLa table memory.default.communes_69 contient maintenant une seule ligne. Tout le document se trouve dans sa colonne doc.
Si ça ne marche pas. Si
curlne télécharge rien, vérifiez votre connexion à internet. L’API est publique et ne demande aucune clé.
Ouvrez maintenant le CLI en mode interactif. Vous taperez les requêtes suivantes après son invite trino>.
$ docker exec -it t484-tuto trinoNote. Sous chaque résultat, le CLI affiche aussi une ligne de statistiques (numéro de la requête, nombre de splits). Nous ne la recopions pas ici.
Nouveauté 1 · JSON_TABLE lit enfin le type JSON
Ce qui change.
- Avant Trino 484. JSON_TABLE, JSON_VALUE, JSON_QUERY et JSON_EXISTS refusaient une colonne de type json. Il fallait d’abord la convertir en texte avec
json_format.- Avec Trino 484. Elles la lisent directement, et NESTED PATH s’applique sans conversion.
- À quoi ça sert. Lire une réponse d’API comme une table, sans étape de conversion.
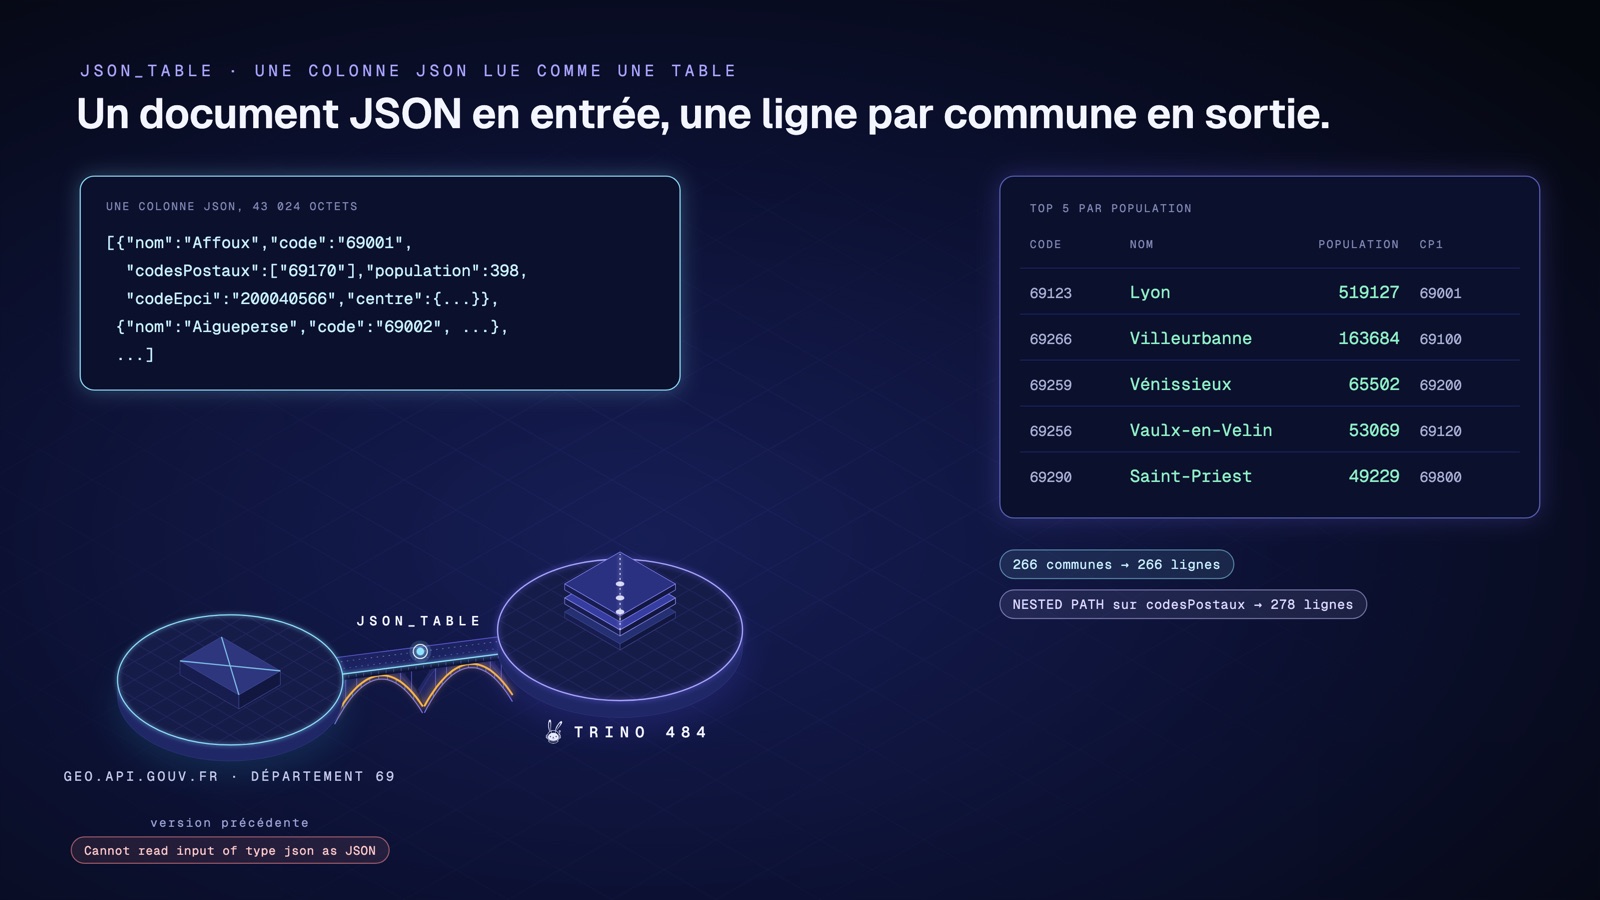
D’après les release notes, quatre fonctions acceptent désormais une colonne de type json : JSON_TABLE, JSON_VALUE, JSON_QUERY et JSON_EXISTS. Avant, elles n’acceptaient que du texte.
Étape 2 · Une ligne par commune
Transformez le document en une ligne par commune, puis gardez les cinq communes les plus peuplées.
trino> SELECT c.code, c.nom, c.population, c.cp1
       FROM memory.default.communes_69 AS g,
            JSON_TABLE(g.doc, 'lax $[*]' COLUMNS (
              code varchar PATH 'lax $.code',
              nom varchar PATH 'lax $.nom',
              population integer PATH 'lax $.population',
              cp1 varchar PATH 'lax $.codesPostaux[0]')) AS c
       ORDER BY c.population DESC
       LIMIT 5;
code | nom | population | cp1
-------+----------------+------------+-------
69123 | Lyon | 519127 | 69001
69266 | Villeurbanne | 163684 | 69100
69259 | Vénissieux | 65502 | 69200
69256 | Vaulx-en-Velin | 53069 | 69120
69290 | Saint-Priest | 49229 | 69800
(5 rows)Le chemin 'lax $[*]' désigne chaque élément de la liste. Chaque PATH indique où lire la valeur d’une colonne. Lyon arrive en tête, avec 519 127 habitants.
Si ça ne marche pas. Si Trino répond
Table 'memory.default.communes_69' does not exist, refaites l’étape 1. Le catalogmemorygarde ses tables en mémoire vive : elles disparaissent quand le conteneur redémarre.
On l’a vérifié. Sur la version précédente, la même requête échoue avec l’erreur
Cannot read input of type json as JSON using formatting JSON. Pour la faire marcher sur les deux versions, il faut écrirejson_format(g.doc), qui transforme d’abord le JSON en texte.
Étape 3 · Une ligne par code postal
Une commune peut avoir plusieurs codes postaux, rangés dans une liste. NESTED PATH ouvre cette liste et crée une ligne par code postal.
trino> SELECT c.nom, c.cp
       FROM memory.default.communes_69 AS g,
            JSON_TABLE(g.doc, 'lax $[*]' COLUMNS (
              nom varchar PATH 'lax $.nom',
              NESTED PATH 'lax $.codesPostaux[*]' COLUMNS (cp varchar PATH 'lax $'))) AS c
       WHERE c.nom = 'Oullins-Pierre-Bénite'
       ORDER BY c.cp;
nom | cp
-----------------------+-------
Oullins-Pierre-Bénite | 69310
Oullins-Pierre-Bénite | 69600
(2 rows)Oullins-Pierre-Bénite a deux codes postaux, donc deux lignes. Lyon en a neuf, de 69001 à 69009. Pour tout le département, on obtient 278 lignes pour 266 communes.
Si ça ne marche pas. Si la requête n’affiche aucune ligne, vérifiez que le nom est écrit exactement, avec ses accents et ses tirets.
Étape 4 · Un vrai nombre, prêt à additionner
JSON_VALUE lit une seule valeur dans le JSON. Avec RETURNING integer, elle renvoie un nombre entier au lieu d’un texte.
trino> SELECT sum(JSON_VALUE(c, 'lax $.population' RETURNING integer)) AS population_totale
       FROM memory.default.communes_69 AS g
       CROSS JOIN UNNEST(CAST(g.doc AS array(json))) AS u(c);
population_totale
-------------------
1914667
(1 row)UNNEST découpe la liste en une ligne par commune. Ensuite, sum() additionne les 266 populations. La version précédente refuse cette requête, avec la même erreur qu’à l’étape 2.
Si ça ne marche pas. Si vous obtenez un autre total, l’API a sans doute été mise à jour. Comparez la taille du fichier avec celle de l’étape 1.
Astuce. Trino 484 ajoute aussi les fonctions JSON_SERIALIZE et json_scalar(). Il sait également convertir une valeur JSON en date avec un cast, par exemple
CAST(JSON '"2026-10-15"' AS date).
Nouveauté 2 · Le JSON garde son ordre et ses nombres
Ce qui change.
- Avant Trino 484. Trino triait les clés par ordre alphabétique, et
4.4116devenait4.4116E0.- Avec Trino 484. Les clés gardent l’ordre de la source, et les nombres gardent leur écriture.
- À quoi ça sert. Republier un document identique à sa source.
- Attention. C’est un breaking change : vérifiez vos tests.
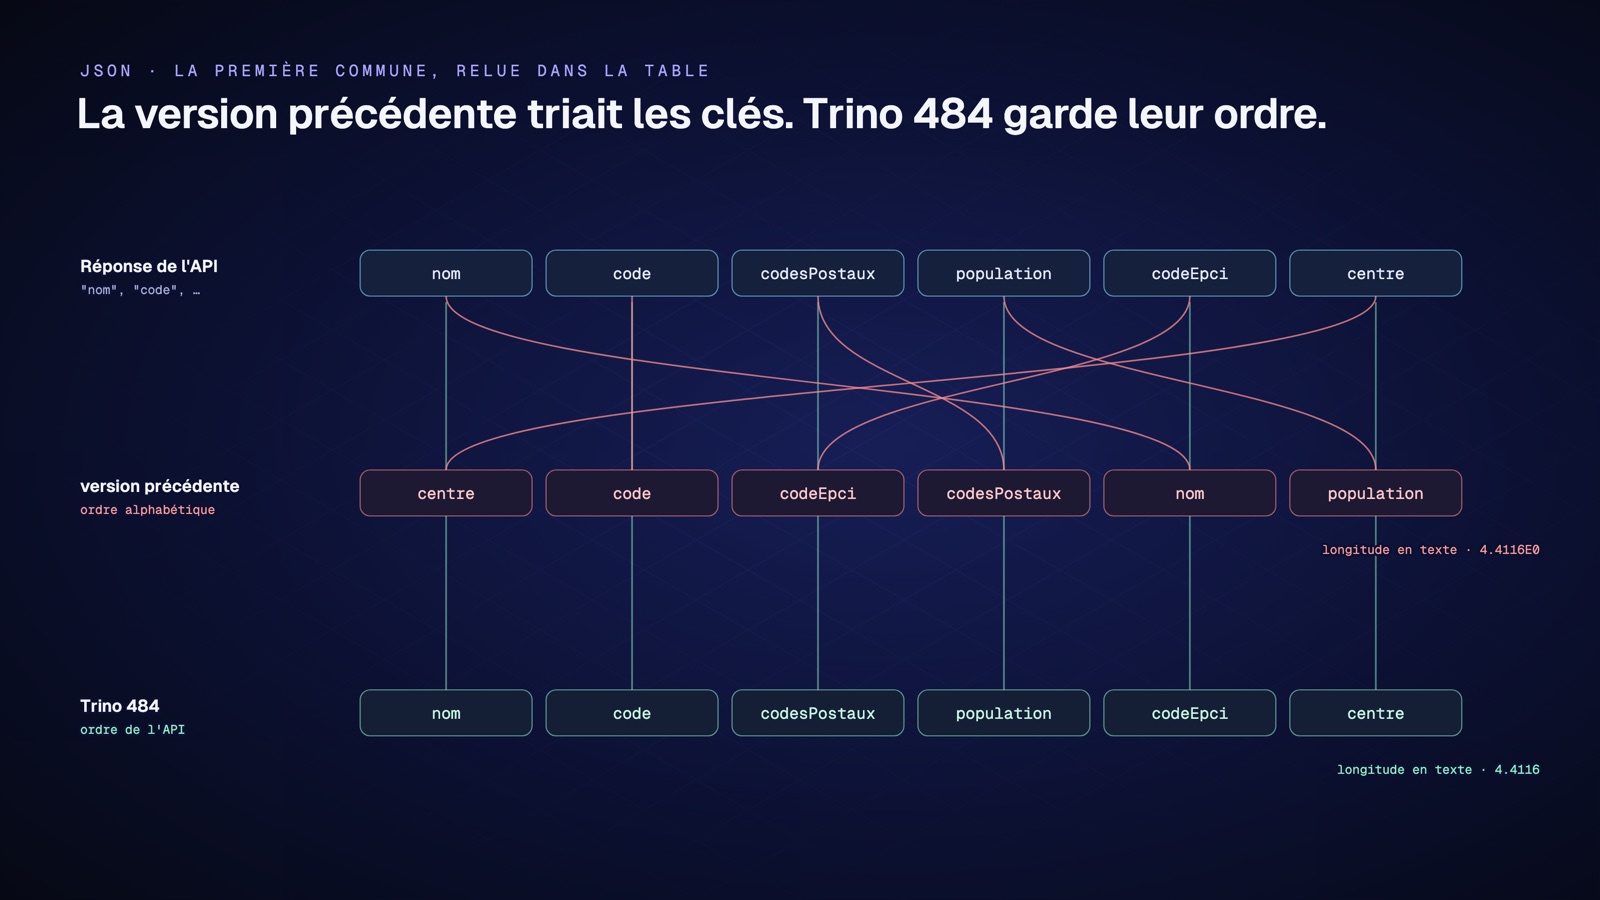
Trino 484 affiche vos documents JSON tels qu’ils sont arrivés : mêmes clés dans le même ordre, nombres écrits de la même façon. La version précédente triait les clés, et elle réécrivait certains nombres en notation scientifique.
Étape 5 · Relire la première commune
Affichez la première commune du document, puis sa longitude.
trino> SELECT json_format(json_extract(doc, '$[0]')) AS premiere_commune
       FROM memory.default.communes_69;
premiere_commune
-----------------------------------------------------------------------------------------------------------------------------------------------------------
{"nom":"Affoux","code":"69001","codesPostaux":["69170"],"population":398,"codeEpci":"200040566","centre":{"type":"Point","coordinates":[4.4116,45.8448]}}
(1 row)Les clés apparaissent dans l’ordre de l’API : nom, code, codesPostaux, et ainsi de suite. La version précédente affichait {"centre":...,"code":"69001",...,"nom":"Affoux","population":398}, avec les clés triées par ordre alphabétique.
trino> SELECT CAST(json_extract(doc, '$[0].centre.coordinates[0]') AS varchar) AS longitude
       FROM memory.default.communes_69;
longitude
-----------
4.4116
(1 row)La longitude reste 4.4116. La version précédente affichait 4.4116E0, en notation scientifique.
Si ça ne marche pas. Si les clés apparaissent triées, vérifiez la version du serveur avec
SELECT version(). Elle doit afficher 484.
Attention. Ces changements peuvent casser l’existant : ce sont des breaking changes. Un test qui comparait l’ancien résultat va échouer. D’après les release notes, les clés en double sont aussi conservées. Nous avons également vérifié que
json_array_get('["a", "b"]', 0)renvoie maintenant"a"au lieu dea.
Nouveauté 3 · Des intervalles au type précis
Ce qui change.
- Avant Trino 484. Une soustraction de timestamps refusait
HOUR TO MINUTE, ethour(INTERVAL '36' HOUR)renvoyait 12.- Avec Trino 484. Vous choisissez les champs de l’intervalle, jusqu’à 12 décimales pour les secondes. Quand HOUR est le premier champ,
hour()le renvoie en entier : 36.- À quoi ça sert. Exprimer une durée dans les unités du métier.
- Attention. C’est un breaking change pour
hour()et EXTRACT.
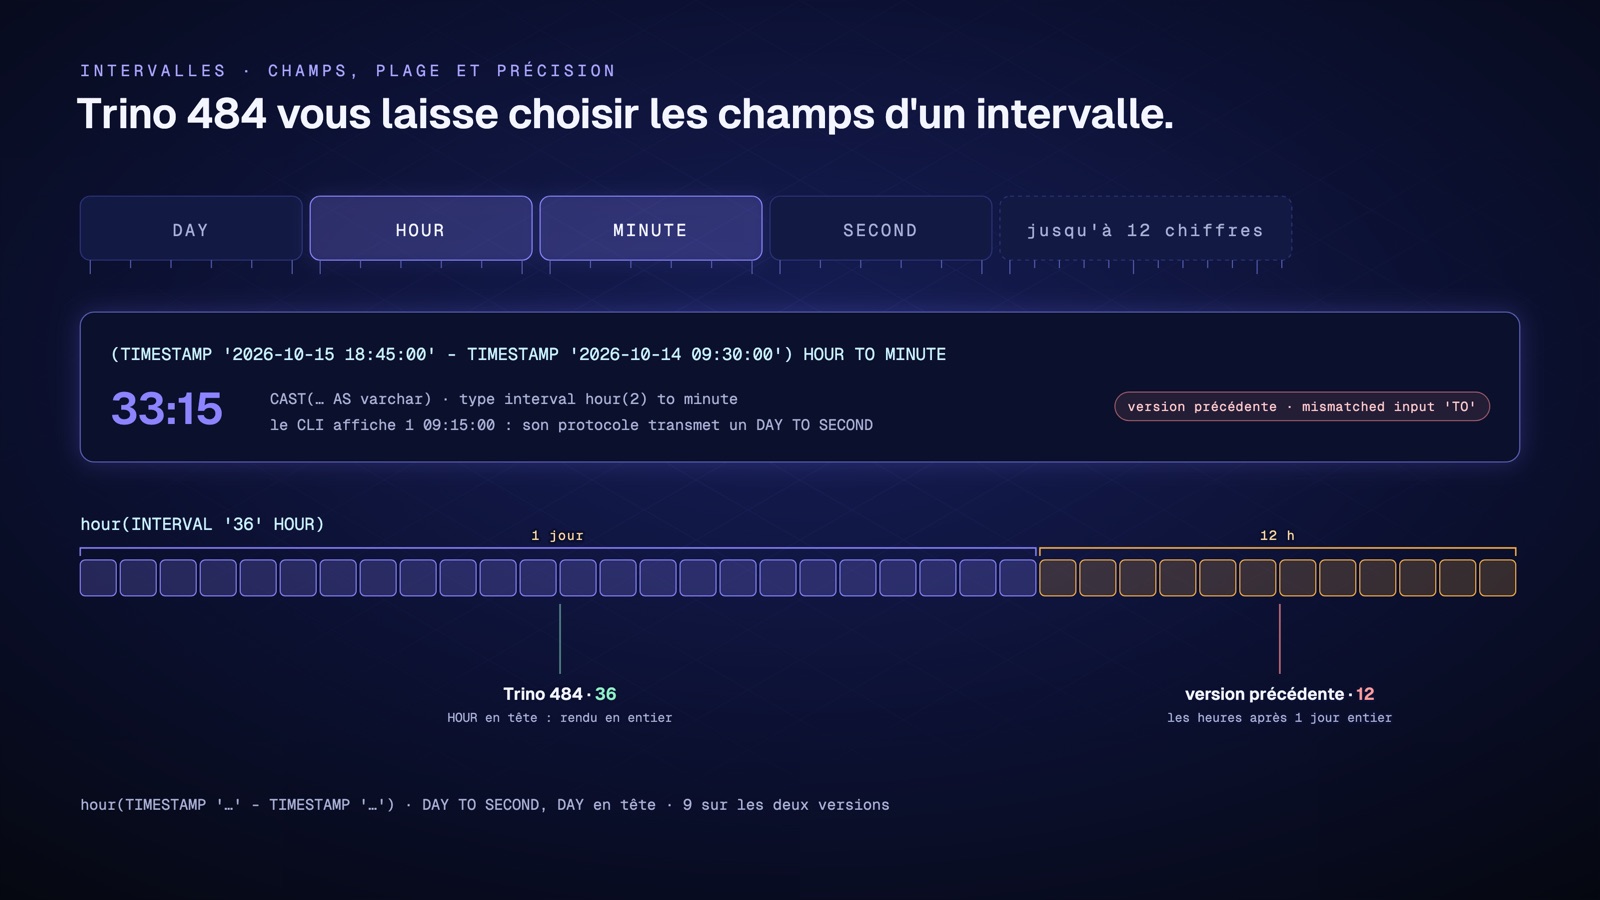
En SQL, une durée s’appelle un intervalle, par exemple 3 jours ou 2 heures. Ses champs fixent ses unités : DAY, HOUR, MINUTE et SECOND pour une durée en jours et en heures. Trino 484 vous laisse choisir ces champs, par exemple des heures et des minutes pour la durée d’un traitement.
Étape 6 · Soustraire deux timestamps en HOUR TO MINUTE
Cette requête soustrait deux timestamps et demande un intervalle de type HOUR TO MINUTE. Elle extrait aussi les heures d’un intervalle de 36 heures.
trino> SELECT (TIMESTAMP '2026-10-15 18:45:00' - TIMESTAMP '2026-10-14 09:30:00') HOUR TO MINUTE AS duree,
              hour(INTERVAL '36' HOUR) AS heures;
duree | heures
------------+--------
1 09:15:00 | 36
(1 row)hour() renvoie bien 36 : quand HOUR est le premier champ de l’intervalle, Trino 484 le rend en entier. La durée, elle, s’affiche 1 09:15:00, soit 1 jour, 9 heures et 15 minutes. Le CLI semble donc ignorer les champs demandés.
Il n’en est rien. Le protocole client de Trino, celui du CLI et du driver JDBC, transmet encore tout intervalle jour-heure en DAY TO SECOND. Le type de la colonne est pourtant bien HOUR TO MINUTE. Vérifiez-le.
trino> SELECT typeof(duree) AS type, CAST(duree AS varchar) AS texte, hour(duree) AS heures
       FROM (SELECT (TIMESTAMP '2026-10-15 18:45:00' - TIMESTAMP '2026-10-14 09:30:00') HOUR TO MINUTE AS duree);
type | texte | heures
----------------------------+-------+--------
interval hour(2) to minute | 33:15 | 33
(1 row)typeof() renvoie interval hour(2) to minute. Converti en texte, l’intervalle vaut 33:15, soit 33 heures et 15 minutes, et hour() renvoie 33. Pour afficher 33:15 dans un outil branché en JDBC, convertissez donc l’intervalle en varchar.
Enfin, sur un intervalle DAY TO SECOND, rien ne change. C’est le type que renvoie une simple soustraction de timestamps.
trino> SELECT hour(TIMESTAMP '2026-10-15 18:45:00' - TIMESTAMP '2026-10-14 09:30:00') AS heure_du_jour; heure_du_jour
---------------
9
(1 row)Ici, le premier champ est DAY. hour() renvoie donc l’heure dans la journée, 9, comme sur la version précédente.
Si ça ne marche pas. Si Trino répond
mismatched input 'TO', le serveur n’est pas en version 484.
Attention. La version précédente refusait
HOUR TO MINUTE(erreurmismatched input 'TO'). Pourhour(INTERVAL '36' HOUR), elle renvoyait 12, les heures restantes une fois le jour entier retiré. Seuls les intervalles dont le premier champ est HOUR, MINUTE, SECOND ou MONTH changent de résultat. Cherchez donc dans vos requêtes les littéraux commeINTERVAL '36' HOURouINTERVAL '14' MONTH, et les calculs qui en dérivent, commeINTERVAL '30' HOUR * 2.
Note. Trino 484 permet aussi de choisir le nombre de chiffres du premier champ, comme dans
INTERVAL '400' DAY(3). Il accepte jusqu’à 12 chiffres après la virgule pour les secondes, comme dansSECOND(1, 12). La version précédente refusait les deux.
Nouveauté 4 · CREATE VIEW IF NOT EXISTS protège la vue existante
Ce qui change.
- Avant Trino 484. CREATE VIEW échouait si la vue existait, et CREATE OR REPLACE VIEW la remplaçait.
- Avec Trino 484.
IF NOT EXISTScrée la vue si elle manque, et laisse en place celle qui existe.- À quoi ça sert. Relancer un script de déploiement sans risque d’écraser une vue.
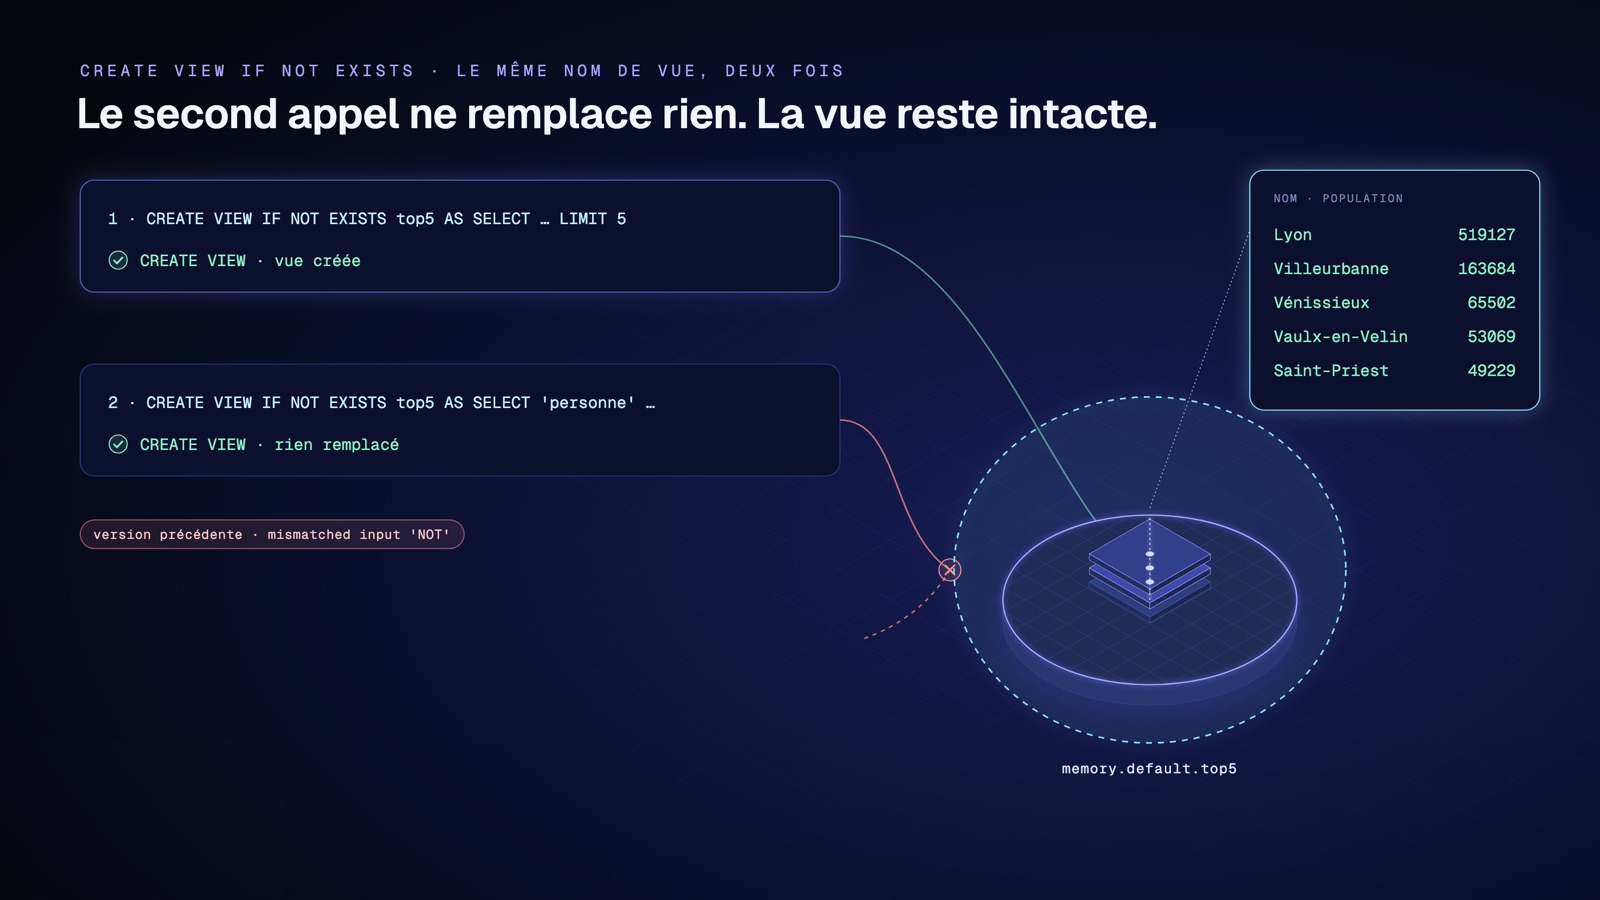
Une vue est une requête enregistrée sous un nom, que l’on interroge comme une table. Avec IF NOT EXISTS, CREATE VIEW la crée seulement si elle n’existe pas encore.
Étape 7 · Une vue des cinq plus grandes communes
Créez une vue des cinq communes les plus peuplées.
trino> CREATE VIEW IF NOT EXISTS memory.default.top5 AS
       SELECT c.nom, c.population
       FROM memory.default.communes_69 AS g,
            JSON_TABLE(g.doc, 'lax $[*]' COLUMNS (
              nom varchar PATH 'lax $.nom',
              population integer PATH 'lax $.population')) AS c
       ORDER BY c.population DESC
       LIMIT 5;
CREATE VIEWLancez à nouveau la même commande, avec une autre définition. C’est ce qui arrive quand un script de déploiement est relancé par erreur.
trino> CREATE VIEW IF NOT EXISTS memory.default.top5 AS SELECT 'personne' AS nom, 0 AS population;CREATE VIEWTrino répond sans erreur. Interrogez la vue pour savoir quelle définition a été gardée.
trino> SELECT nom, population FROM memory.default.top5 ORDER BY population DESC; nom | population
----------------+------------
Lyon | 519127
Villeurbanne | 163684
Vénissieux | 65502
Vaulx-en-Velin | 53069
Saint-Priest | 49229
(5 rows)C’est la première définition qui est restée. La seconde commande n’a rien remplacé.
Si ça ne marche pas. Si la seconde commande échoue en disant que la vue existe déjà, vérifiez qu’elle contient bien
IF NOT EXISTS.
On l’a vérifié. La version précédente refuse cette écriture, avec l’erreur
mismatched input 'NOT'. Il fallait choisir entre deux commandes. CREATE VIEW échoue si la vue existe. CREATE OR REPLACE VIEW la remplace.
Nouveauté 5 · EXCLUDE compare une ligne aux autres
Ce qui change.
- Avant Trino 484. La clause EXCLUDE était refusée. Il fallait calculer la moyenne des autres à la main.
- Avec Trino 484. EXCLUDE est accepté. CURRENT ROW retire la ligne courante. GROUP retire la ligne courante et ses ex aequo, TIES retire seulement les ex aequo.
- À quoi ça sert. Comparer une ligne à la moyenne des autres, en une seule window function.
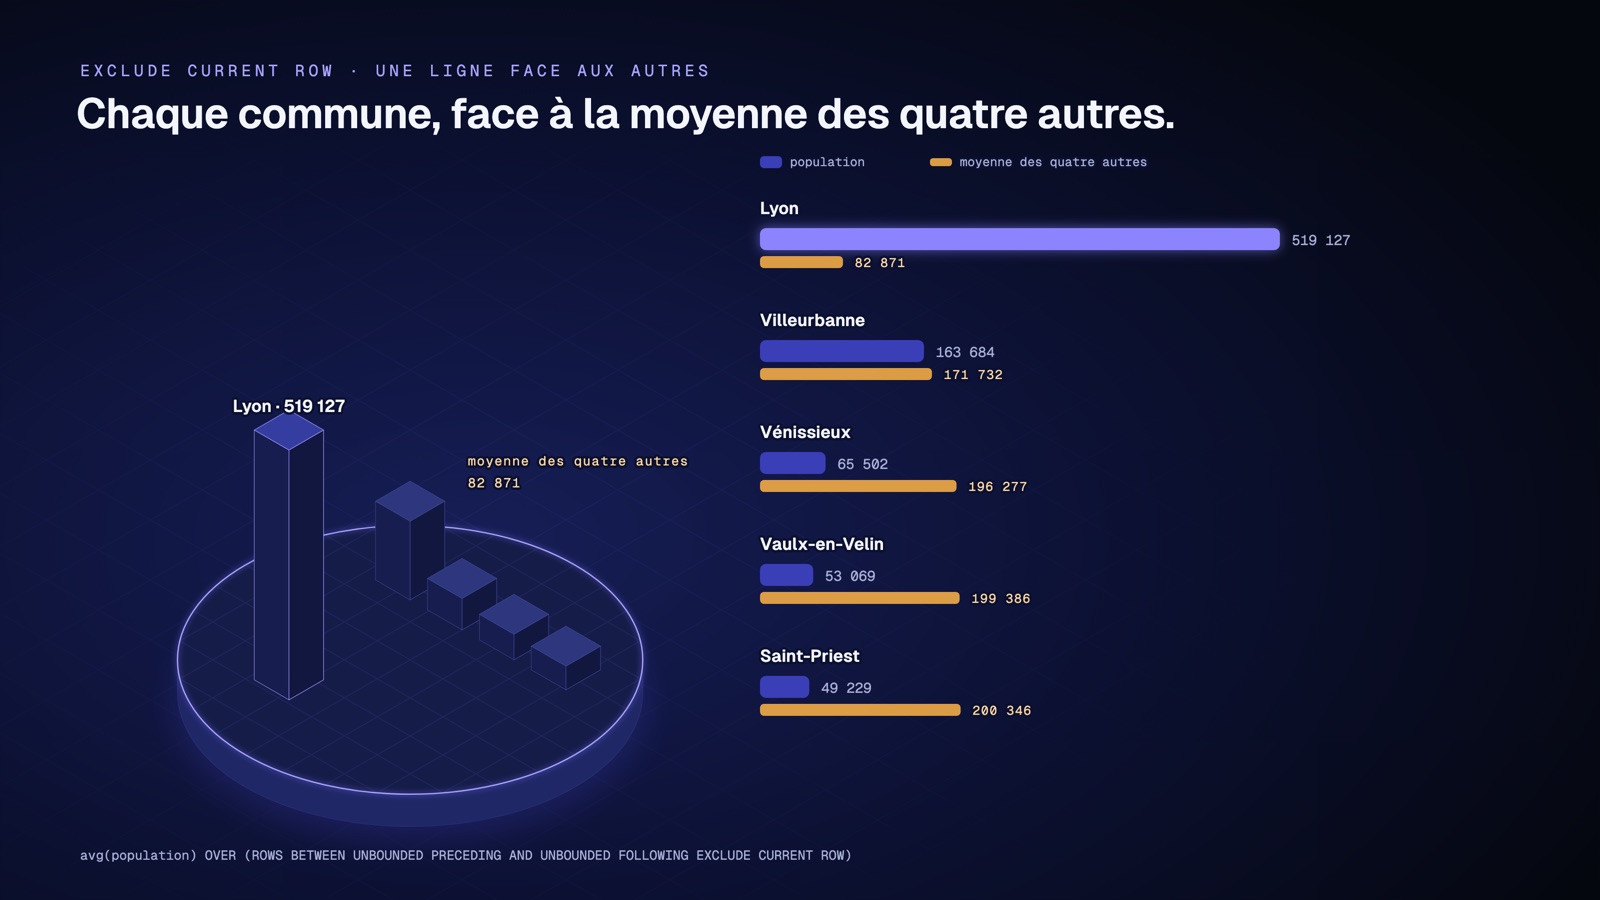
Une window function calcule une valeur sur un ensemble de lignes, le window frame. EXCLUDE retire certaines lignes de ce frame. Avec EXCLUDE CURRENT ROW, chaque ligne se compare à la moyenne des autres, sans compter sa propre valeur.
Étape 8 · Chaque commune face aux quatre autres
Calculez, pour chaque commune de la vue, la population moyenne des quatre autres.
trino> SELECT nom, population,
              round(avg(population) OVER (
                ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
                EXCLUDE CURRENT ROW)) AS moyenne_des_autres
       FROM memory.default.top5
       ORDER BY population DESC;
nom | population | moyenne_des_autres
----------------+------------+--------------------
Lyon | 519127 | 82871.0
Villeurbanne | 163684 | 171732.0
Vénissieux | 65502 | 196277.0
Vaulx-en-Velin | 53069 | 199386.0
Saint-Priest | 49229 | 200346.0
(5 rows)Lyon compte 519 127 habitants, contre 82 871 en moyenne pour les quatre autres. Sans EXCLUDE, Lyon serait comptée dans sa propre moyenne.
Si ça ne marche pas. Si Trino répond
Table 'memory.default.top5' does not exist, refaites l’étape 7.
Note. Deux autres variantes s’appuient sur l’ORDER BY de la fenêtre. EXCLUDE GROUP met de côté la ligne courante et ses ex aequo, c’est-à-dire les lignes de même clé de tri. EXCLUDE TIES met de côté les ex aequo seulement. Sans ORDER BY, comme à l’étape 8, toutes les lignes sont ex aequo : EXCLUDE GROUP y renverrait NULL sur chaque ligne. La version précédente refuse la clause EXCLUDE, avec l’erreur
mismatched input 'EXCLUDE'.
Nouveauté 6 · Des résultats faux corrigés
Ce qui change.
- Avant Trino 484. Avec une liste de valeurs consécutives contenant NULL,
x NOT IN (1, 2, 3, NULL)renvoyaittruepour x = 5. Un cumul bigint débordait aussi sans erreur.- Avec Trino 484. Trino renvoie NULL, comme le prévoit la norme SQL, et signale le débordement par une erreur.
- À quoi ça sert. Obtenir des résultats justes. Une requête peut désormais renvoyer NULL ou une erreur, là où elle donnait un chiffre faux.
Trino 484 corrige des requêtes qui donnaient une réponse fausse sans afficher la moindre erreur. Ce sont les plus dangereuses : rien ne vous alerte.
Étape 9 · NOT IN avec un NULL dans la liste
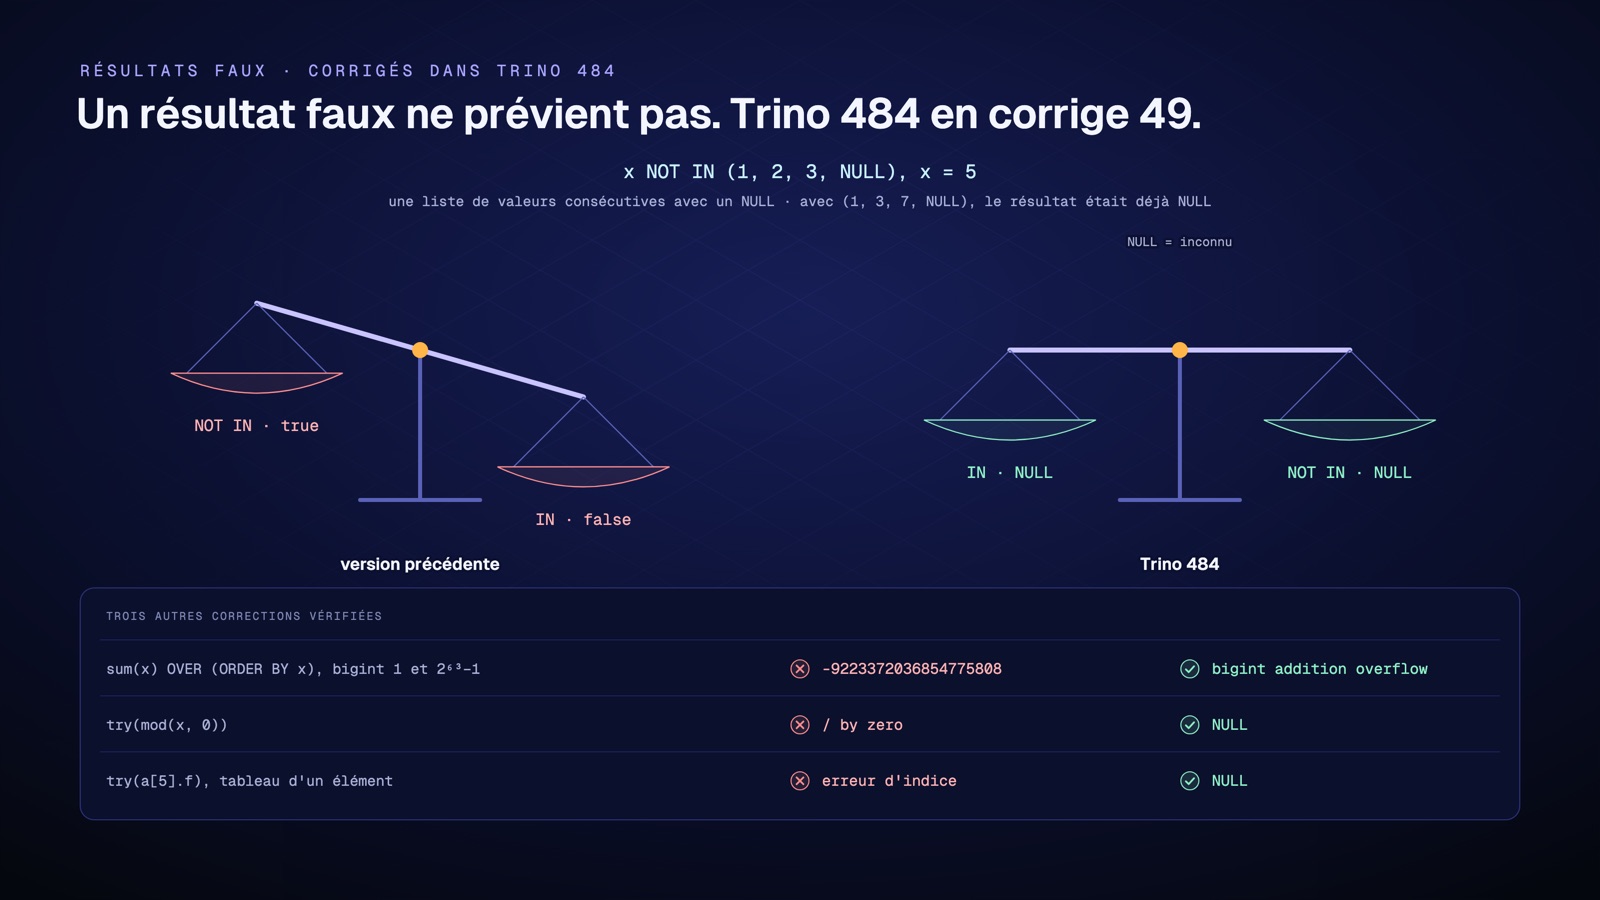
En SQL, NULL veut dire « valeur inconnue ». 5 NOT IN (1, 2, 3, NULL) doit donc valoir NULL : Trino ne peut pas savoir si la valeur inconnue vaut 5. La version précédente se trompait quand la liste contenait des valeurs consécutives, comme 1, 2, 3. Testez-le.
trino> SELECT x, x IN (1, 2, 3, NULL) AS in_list, x NOT IN (1, 2, 3, NULL) AS not_in_list
       FROM (VALUES 2, 5) AS t(x)
       ORDER BY x;
x | in_list | not_in_list
---+---------+-------------
2 | true | false
5 | NULL | NULL
(2 rows)Avec x = 5, Trino 484 affiche NULL dans les deux colonnes, comme le prévoit la norme SQL. Dans un WHERE, cette ligne est donc écartée.
Si ça ne marche pas. Si vous voyez
falseettruepour x = 5, votre serveur n’a pas encore la correction.
On l’a vérifié. Sur la version précédente, la même requête affichait
falseettruepour x = 5. Avec une liste de valeurs non consécutives, comme(1, 3, 7, NULL), elle renvoyait déjà NULL. Le schéma montre trois autres corrections que nous avons vérifiées.
Nouveauté 7 · Iceberg accepte sorted_by et gc_enabled
Ce qui change.
- Avant Trino 484. La procédure
optimizerefusaitsorted_by, la propriétégc_enabledn’existait pas, et les vues matérialisées n’acceptaient ni COMMENT ni optimize.- Avec Trino 484. Les quatre instructions sont acceptées. Dans notre test, sur une petite table,
optimizen’a réécrit aucun fichier : le tri n’a donc pas été exercé.- À quoi ça sert. Trier par la colonne la plus filtrée et, selon les release notes, protéger les fichiers qu’un autre moteur lit.
Iceberg est un format de table très utilisé pour les données stockées en fichiers. La compaction regroupe ses petits fichiers en gros fichiers. Trino 484 accepte un ordre de tri pendant cette compaction. Selon les release notes, il sait aussi protéger les fichiers d’une table contre la suppression.
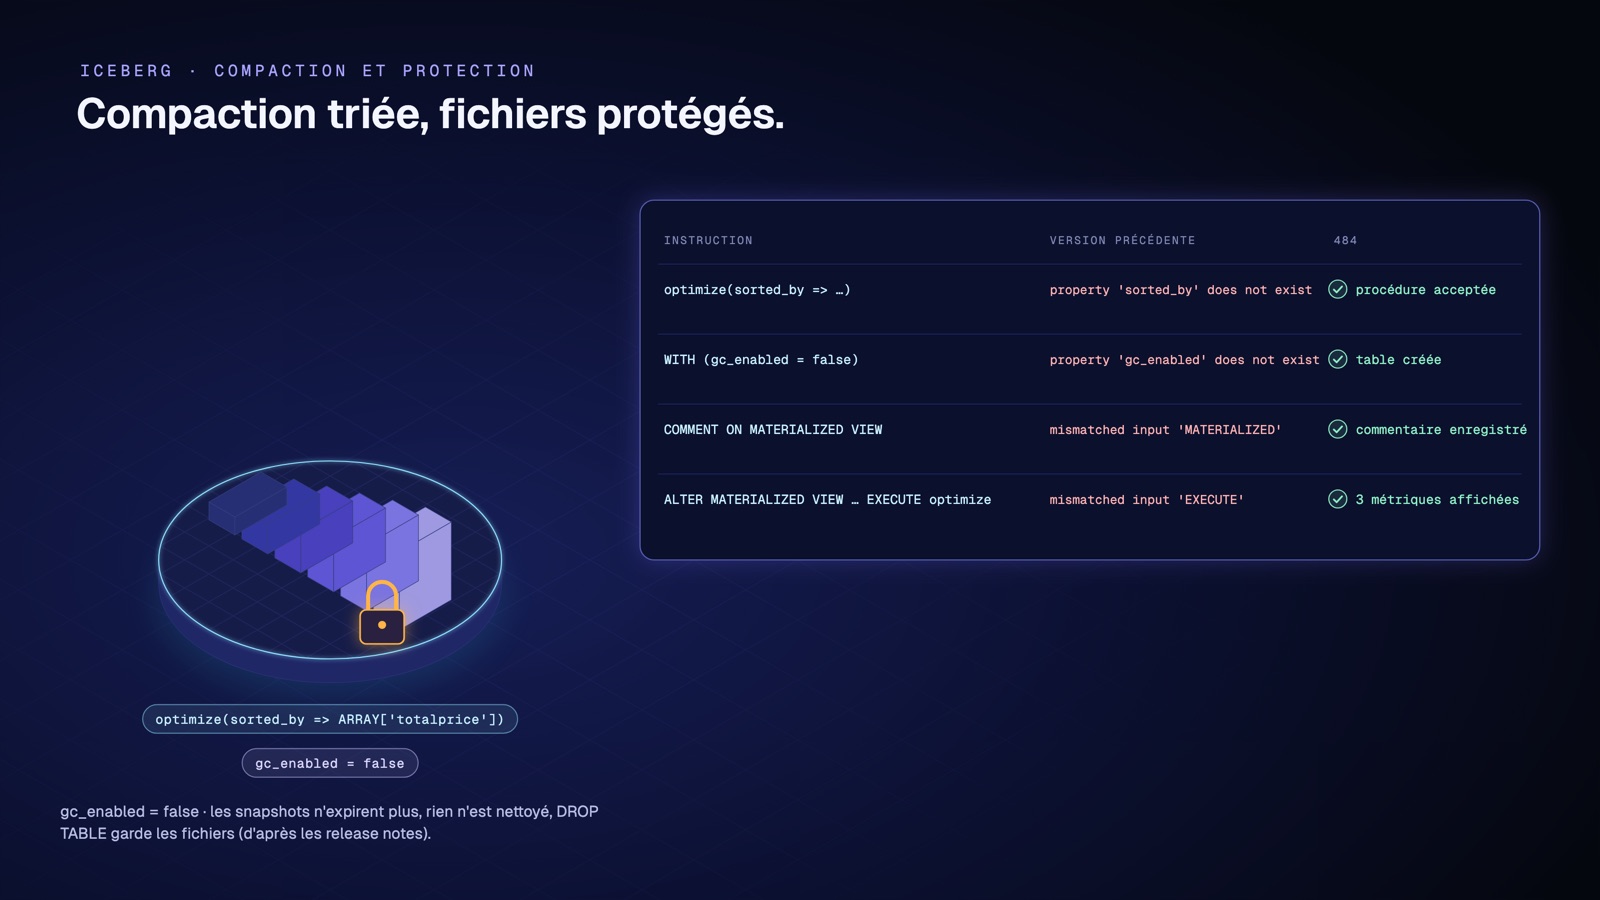
L’image officielle ne contient pas de catalog Iceberg. Nous avons donc testé cette partie à part, sur une installation Iceberg locale.
| Instruction | Version précédente | Trino 484 |
|---|---|---|
optimize(sorted_by => ARRAY['totalprice']) |
property 'sorted_by' does not exist |
procédure acceptée, trois métriques affichées |
WITH (gc_enabled = false) |
table property 'gc_enabled' does not exist |
table créée |
COMMENT ON MATERIALIZED VIEW |
mismatched input 'MATERIALIZED' |
commentaire enregistré |
ALTER MATERIALIZED VIEW ... EXECUTE optimize |
mismatched input 'EXECUTE' |
trois métriques affichées |
D’après les release notes, gc_enabled = false protège les fichiers de la table. Les anciens snapshots n’expirent plus, les fichiers orphelins ne sont plus nettoyés, et DROP TABLE ne supprime plus les fichiers.
Récapitulatif du tutoriel
Vous avez suivi dix étapes, de l’étape 0 à l’étape 9, sur de vraies données publiques.
| Étape | Ce que vous avez fait | Nouveauté de Trino 484 |
|---|---|---|
| 0 et 1 | lancé Trino et chargé 266 communes | aucune, préparation |
| 2 à 4 | lu le JSON en table, déplié les codes postaux, additionné les populations | JSON_TABLE, JSON_VALUE sur le type json |
| 5 | relu une commune et sa longitude | ordre des clés et nombres gardés |
| 6 | soustrait deux timestamps en HOUR TO MINUTE, puis vérifié le type | intervalles précis |
| 7 | créé une vue sans l’écraser | CREATE VIEW IF NOT EXISTS |
| 8 | comparé chaque commune aux autres | EXCLUDE CURRENT ROW |
| 9 | vu NOT IN renvoyer NULL | résultat faux corrigé |
Quittez le CLI avec quit, puis supprimez le conteneur et les fichiers.
$ docker rm -f t484-tuto
$ rm communes-69.json charger.sqlt484-tutoDocker confirme en affichant le nom du conteneur. Avant de passer votre cluster à Trino 484, lisez la section Avant de migrer.
Et aussi
Nous avons aussi testé quatre nouveautés utiles à l’exploitation. Le réglage query.max-output-data-size arrête une requête qui renvoie trop de données (erreur EXCEEDED_OUTPUT_LIMIT). Le CLI et le driver JDBC savent se connecter avec OAuth 2.0 en mode client credentials, sans navigateur. Dans les règles d’accès écrites dans un fichier, {user} désigne l’utilisateur connecté : chacun peut ainsi avoir son propre schéma. Enfin, Trino peut transmettre à OPA les extra credentials que vous listez, et seulement ceux-là.
Les release notes annoncent aussi un cache de fichiers commun à tous les catalogs, et, dans leur section générale, 25 améliorations de vitesse ou de mémoire (67 sur l’ensemble des rubriques). Nous ne les avons pas mesurées.
Avant de migrer
- L’image Docker change de base. Elle repose maintenant sur l’image Red Hat Hardened core runtime, une base allégée. Nous avons constaté que
grep,sed,awketfindn’y sont plus, et que le scriptrun-trinoa disparu. Si votrenode.propertiesne fixe pasnode.id, chaque démarrage choisit un nouvel identifiant au hasard. Les release notes donnent la solution,node.id=${ENV:HOSTNAME}. - Les majuscules des noms d’utilisateur sont conservées dans GRANT, REVOKE, SET AUTHORIZATION et CREATE SCHEMA. Les noms de rôles restent en minuscules. Nous l’avons vérifié : après
GRANT ... TO USER Alice, Alice peut lire la table, mais pas alice. - Le JSON affiché change. L’ordre des clés, les doublons et l’écriture décimale sont conservés. D’après les release notes, les nombres restent des nombres dans JSON_ARRAY et JSON_OBJECT. Un JSON ne peut plus dépasser 1 024 niveaux imbriqués. Et JSON_SERIALIZE devient un mot réservé.
- Les intervalles aussi. Quand le premier champ d’un intervalle est HOUR, MINUTE, SECOND ou MONTH, la fonction qui l’extrait le renvoie en entier : 36 pour
hour(INTERVAL '36' HOUR), et non plus 12. Sur un intervalle DAY TO SECOND, commefin - debut, rien ne change :hour()renvoie toujours l’heure dans la journée. Cherchez donc les littérauxINTERVAL '...' HOUR,MINUTE,SECONDouMONTHqui dépassent l’unité suivante, et les calculs qui en dérivent. EXTRACT refuse un champ absent de l’intervalle. Un intervalle de type day-time ne peut plus dépasser environ 292 000 ans. - Hive et Iceberg. La valeur par défaut de
hive.storage-formatdevient PARQUET. Les réglagesfs.cache.*passent dans le cache manager, et les catalogs ne gardent quefs.cache.enabled. Les tables$snapshots,$historyet$metadata_log_entriesaffichent leurs timestamps en UTC. - Plugins maison. Plusieurs changements de l’interface des plugins (la SPI) obligent à les recompiler.
- Plateformes. L’image ppc64le disparaît, et le connecteur Cassandra exige Cassandra 4.0 ou plus.
Testez-vous
1. Pourquoi la requête de l'étape 2 échoue-t-elle sur la version précédente ?
La colonne doc est de type json, et JSON_TABLE n’acceptait que du texte. Il fallait d’abord la convertir en texte avec json_format(g.doc).
2. Que renvoie hour(INTERVAL '36' HOUR) sur Trino 484 ?
36, car HOUR est le premier champ de l’intervalle. La version précédente renvoyait 12, les heures restantes après un jour entier.
3. Que vaut 5 NOT IN (1, 2, 3, NULL) ?
NULL. La valeur inconnue pourrait valoir 5, donc Trino ne peut pas conclure. Dans un WHERE, la ligne est écartée.
Ce que vous avez appris
Dans ce tutoriel, vous avez appris à :
- lancer Trino 484 sur votre poste en une commande ;
- lire une réponse d’API JSON comme une table, avec JSON_TABLE ;
- déplier un tableau imbriqué en lignes, avec NESTED PATH ;
- soustraire deux timestamps en choisissant les champs de l’intervalle obtenu ;
- créer une vue sans écraser celle qui existe ;
- comparer une ligne à la moyenne des autres, avec EXCLUDE ;
- repérer un résultat faux que Trino 484 corrige.
Pour aller plus loin, lisez les release notes de Trino 484, parcourez la documentation des fonctions JSON, et relisez la section Avant de migrer avant toute mise à jour.
Questions fréquentes
Quelles sont les nouveautés de Trino 484 ?
Trino 484, sorti le 15 octobre 2026, gère mieux le JSON de la norme SQL : JSON_TABLE et JSON_VALUE acceptent le type json, et les fonctions JSON_SERIALIZE et json_scalar() sont ajoutées. Il apporte aussi des intervalles précis jusqu'à 12 décimales, la clause EXCLUDE dans les window frames, CREATE VIEW IF NOT EXISTS et, pour Iceberg, COMMENT et optimize sur les vues matérialisées, gc_enabled et le tri sorted_by. Ses release notes comptent 380 entrées, dont 54 entrées de résultats faux corrigés (49 corrections distinctes) et 45 breaking changes (39 distincts).
Quand Trino 484 est-il sorti ?
Le 15 octobre 2026, d'après ses release notes.
Trino prend-il en charge JSON_TABLE et JSON_SERIALIZE ?
Oui. JSON_TABLE existait déjà, mais seulement sur du texte. Depuis la version 484, il accepte aussi une colonne de type json. La fonction JSON_SERIALIZE, la fonction json_scalar() et le constructeur JSON(...) sont nouveaux.
Comment calculer une moyenne qui exclut la ligne courante dans Trino ?
Avec EXCLUDE CURRENT ROW dans le window frame, depuis la version 484.
Pourquoi mon Trino 484 dans Docker a-t-il un node.id aléatoire ?
Le script run-trino, qui utilisait le nom d'hôte du conteneur comme identifiant, a disparu de l'image. Ajoutez node.id=${ENV:HOSTNAME} à votre node.properties.
Trino 484 corrige-t-il des résultats faux ?
Oui. Nous avons compté 54 entrées qui mentionnent des « incorrect results » corrigés, soit 49 corrections distinctes, dont 31 entrées dans la section générale. Le critère est simple : l'entrée contient « incorrect results », « incorrect query results » ou « incorrect NULL results ».